
기사 핵심 요약
MIT 연구진이 AI 모델 간 내부 연산 상태를 직접 전송하는 스웜 텔레파시 기술을 공개했다.
- 스웜 텔레파시는 텍스트 요약 대신 내부 연산 상태인 KV 캐시를 직접 변환해 전송한다.
- 기존 텍스트 전달 방식 대비 처리 시간을 4배 단축하고 평균 정확도를 40% 끌어올렸다.
- 이기종 모델 본체의 미세조정 없이 단일 GPU 하루 미만의 경량 변환기 학습으로 구동된다.
인공지능 모델끼리 텍스트 요약본을 주고받지 않고 내부 연산 상태를 직접 전송해 소통하는 스웜 텔레파시 기술이 등장했다. 미국 매사추세츠공과대학교 컴퓨터과학·인공지능연구소(MIT CSAIL)와 MIT-IBM 컴퓨팅 연구소 연구진은 온라인 아카이브를 통해 '스웜 텔레파시: 모델 계열 간 프리필 없는 KV 캐시 전송(Swarm Telepathy: Prefill-Free KV-Cache Transfer Across Families)' 논문을 발표하고 관련 기술을 공개했다. 연구진이 스웜 텔레파시(SwaT·Swarm Telepathy)로 명명한 이 방식은 서로 다른 제조사가 개발한 인공지능 사이에서 텍스트 변환 과정을 건너뛰고 계산 자원을 절감하도록 설계됐다.
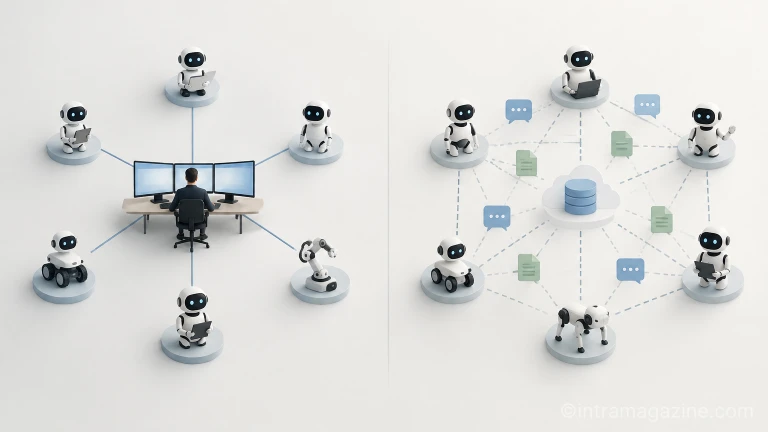
기존 멀티 에이전트 시스템은 개별 인공지능이 계산 결과를 자연어 문맥으로 요약해 다음 모델에 넘겨주는 구조로 운영됐다. 정보를 넘겨받은 수신 모델은 전달받은 텍스트를 처음부터 다시 읽어 들이는 프리필(prefill) 연산을 거쳐야 했다. 이 과정에서 요약문에 미처 반영되지 않은 맥락이 유실되거나, 텍스트 생성과 재독해에 대규모 연산 자원이 추가 소모되는 한계가 꾸준히 지적됐다.
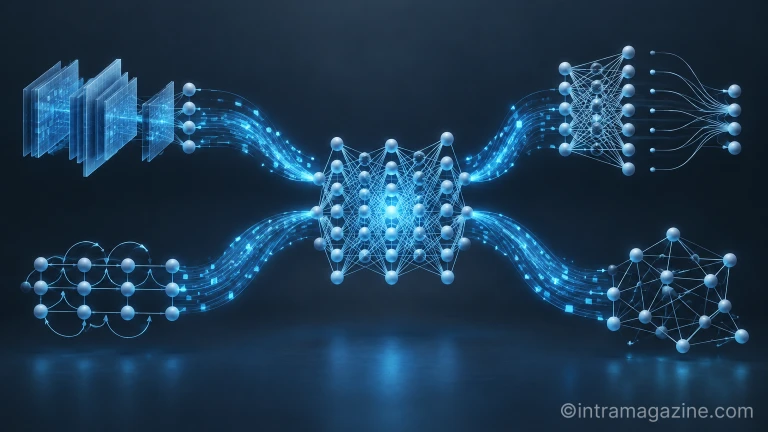
KV 캐시 직접 변환으로 텍스트 프리필 과정 생략
스웜 텔레파시는 인공지능이 문맥을 계산하면서 축적해 둔 내부 데이터 상태인 '키-값(KV) 캐시'를 상대 모델이 읽을 수 있는 형태로 실시간 변환한다. 인공지능 언어 모델은 입력 데이터를 순차적으로 처리하며 다음 토큰을 생성하는 데 필요한 정보를 KV 캐시에 저장하는데, SwaT는 이 연산 자원을 추출해 전달 매개체로 삼는다. 송신 인공지능과 수신 인공지능의 내부 아키텍처가 완전히 일치하지 않아도 중간 변환기가 양측의 규격을 맞춰 준다.
두 인공지능 모델 본체를 재학습하거나 미세조정(파인튜닝)할 필요가 없다는 점도 특징이다. 연구진은 송신 모델과 수신 모델은 고정해 둔 채 중간에서 신호를 변환하는 경량 변환기만 별도로 훈련했다. 이 변환기 훈련에는 고유 토큰 약 4,400만 개와 단일 GPU 기준 하루 미만의 자원만이 소요돼 인프라 구축 부담을 대폭 낮췄다.
정확도 40% 향상과 처리 시간 4배 단축 입증
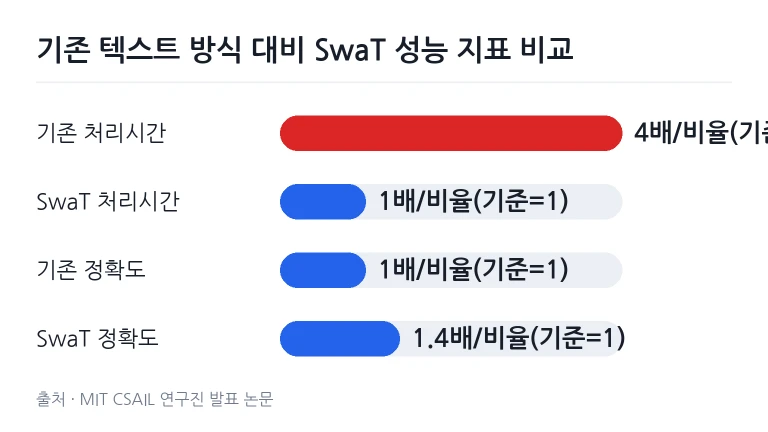
연구진은 캐시 압축 기법인 어텐션 매칭(Attention Matching)을 SwaT와 결합해 성능 시험을 진행했다. 대화 및 독해 벤치마크 평가 결과, 자연어 텍스트 요약본을 거쳐 지식을 전달하는 기존 방식보다 평균 정확도가 40% 향상됐으며 전체 처리 소요 시간은 평균 4분의 1로 단축됐다. 텍스트를 문장 형태로 생성하는 단계와 이를 수신 모델이 다시 입력받아 읽어 내는 프리필 연산이 완전히 생략된 결과다.
기존 텍스트 요약 전달 방식과 SwaT 기반 직접 전송 방식의 성능 차이는 정량 시험에서 뚜렷하게 확인됐다.
| 구분 | 정보 전달 매개체 | 프리필 단계 | 상대 정확도 | 처리 소요 시간 |
|---|---|---|---|---|
| 기존 에이전트 방식 | 자연어 텍스트 요약본 | 필수 (재독해 필요) | 기준 (100%) | 기준 (4배) |
| 스웜 텔레파시 (SwaT) | 변환된 KV 캐시 | 생략 (프리필 불필요) | 40% 향상 (140%) | 4배 단축 (1/4 수준) |
연구진은 변환기 소스코드를 오픈소스 플랫폼 깃허브(GitHub)에 공개해 누구나 아키텍처를 검증하고 후속 연구에 활용할 수 있도록 지원했다.
이기종 모델 간 시각 정보 및 언어 지식 전달
SwaT의 범용성 시험에는 다양한 제조사의 오픈소스 및 상용 인공지능 모델이 투입됐다. 실험에 참여한 모델은 메타의 '라마', 알리바바의 '큐원', 구글의 '젬마', IBM의 '그래나이트', 미스트랄의 '미니스트랄', 허깅페이스의 '스몰LM' 등이다. 연구진은 큐원에서 라마로 정보를 보내거나 젬마에서 큐원 및 그래나이트로 데이터를 전달하는 등 서로 다른 설계 기반 모델 간 연동을 실증했다.
시각적 이해 능력을 언어 전용 모델로 이식하는 멀티모달 실험도 진행됐다. 이미지를 인식할 수 있는 구글 젬마 모델이 사진 자료를 분석한 뒤 그 내부 상태를 SwaT로 텍스트 전용 모델에 전송한 결과, 단순 텍스트 묘사문만 전달받았을 때보다 시각 정보 관련 질문에 대한 답변 정확도가 크게 높았다. 영어 텍스트 데이터셋으로만 훈련된 변환기가 시각 계열 잠재 정보까지 무리 없이 전달할 수 있음을 보여 준 대목이다.
다국어 지식 전달 시험에서도 실질적 결과가 나타났다. 중국어 데이터 처리에 강점이 있는 큐원 3 4B의 내부 연산 상태를 라마 3 8B로 전달하자, 라마는 중국어 종합 평가 벤치마크인 'CMMLU' 내 67개 전 과목에서 성능이 일제히 상승했다. 이를 통해 큐원과 라마 사이에 존재하던 기준 점수 격차의 약 4분의 3이 좁혀졌다. 오픈소스 진영에서 다양한 특화 모델의 역량을 결합하는 에이전트 AI 시스템 구축 시 실질적인 성능 확장을 기대할 수 있는 구조다.
변환기 확장성과 보안 감사 과제 남아
다양한 성과에도 불구하고 스웜 텔레파시가 현시점에서 모든 인공지능을 즉시 하나로 묶는 범용 통신 표준인 것은 아니다. 송신 모델과 수신 모델의 쌍마다 개별 변환기를 각각 훈련해야 하므로 연동할 모델 수가 늘어날수록 구축 및 유지관리 비용이 가파르게 증가한다. 연구진은 다수 모델이 단일 공간에서 소통할 수 있는 '공유 잠재 공간(Shared Latent Space)'을 설계해 변환기 조합 수를 줄이는 연구를 차기 과제로 제시했다.
다자간 연속 통신 과정에서의 정보 보존력도 개선이 필요하다. 텍스트와 달리 수치 행렬 기반인 KV 캐시는 여러 단계에 걸쳐 반복 결합하거나 누적할 경우 원본 데이터가 왜곡되거나 손상될 위험이 존재한다. 여러 차례 메시지를 주고받는 복합 협업 환경에서 캐시 손실을 억제하는 기술 보완이 요구된다.
보안 및 거버넌스 감사 가능성 역시 중요한 해결 과제다. 현재 구조는 송신 모델이 다룬 원본 텍스트 기록에 접근할 수 있어 기초적인 모니터링이 지원된다. 하지만 압축 전달되는 내부 KV 캐시에는 입력 텍스트에 겉으로 드러나지 않은 잠재 연산 정보까지 포함될 수 있다. 전송 효율을 해치지 않으면서도 내부 캐시의 유해성이나 비인가 데이터 포함 여부를 점검할 수 있는 감사 프레임워크 구축이 병행돼야 한다.
스웜 텔레파시는 모델이 자의식을 갖고 텔레파시를 주고받는 기술이 아니라 연산 중간 데이터를 최적화해 전달하는 파이프라인이다. 인간의 언어 형식을 빌리지 않고도 서로 다른 내부 상태를 공유할 수 있는 데이터 인터페이스가 마련된 만큼 향후 복합 인공지능 협업 생태계의 성능 개선이 이어질 전망이다.
같은 주제 기사 모아보기
IT테크 관련 기사 더 보기자주 묻는 질문
스웜 텔레파시 기술의 핵심 원리는 무엇인가요?
AI 모델이 연산 과정에서 축적한 내부 키-값(KV) 캐시를 중간 변환기를 통해 상대 모델이 이해할 수 있는 형태로 직접 전달하는 원리입니다.
기존 멀티 에이전트 소통 방식보다 어떤 점이 우수한가요?
텍스트를 생성하고 수신 모델이 다시 읽는 프리필 연산이 생략되어 처리 시간이 4배 단축되고 맥락 유실이 줄어 정확도가 40% 향상됩니다.
적용을 위해 모델 자체를 새로 학습해야 하나요?
발신 모델과 수신 모델은 고정해 두고 중간 신호 변환기만 단일 GPU 기준 하루 미만으로 별도 훈련하므로 본체 미세조정이 필요하지 않습니다.
댓글을 남기려면 로그인 해주세요.