
기사 핵심 요약
구글 딥마인드가 제미나이 4 카본을 공개하며 글로벌 종합 성능 지표 1위를 되찾았다.
- 아티피셜 애널리시스 인텔리전스 지수에서 59점을 기록해 전체 1위를 차지했다.
- 사이버 보안 패치 생성 및 장시간 자율 에이전트 작업 능력을 대폭 끌어올렸다.
- 초기에는 보안 전문가와 검증된 협력사를 대상으로 순차 제공된다.
구글 딥마인드가 28일(현지시간) 공식 블로그에서 차세대 플래그십 인공지능(AI) 모델 '제미나이 4 카본(Gemini 4 Carbon)'(이하 카본)을 공개하며 글로벌 종합 성능 평가 1위에 올랐다. 구글이 외부 AI 종합 성능 지표에서 정상을 되찾은 것은 지난해 11월 '제미나이 3 프로' 이후 약 11개월 만이다. 직전 모델인 '제미나이 4 아르곤'을 내놓은 지 2주 만에 투입된 카본은 추론 능력과 사이버 보안, 장시간 자율 작업 수행력을 집중 보강했다.
코라이 카부쿠오글루 구글 딥마인드 수석 부사장은 "제미나이 4 카본은 최고 수준의 사이버 보안과 장시간 작업 수행 능력을 갖춘 우리의 가장 강력한 모델"이라고 밝혔다. 순다르 피차이 구글 최고경영자(CEO)도 소셜미디어를 통해 "불과 2주 전 출시한 아르곤에 이어 카본은 우리가 얼마나 빠르게 기술 혁신을 추진하고 있는지 보여주는 좋은 사례"라며 개발 속도를 강조했다.
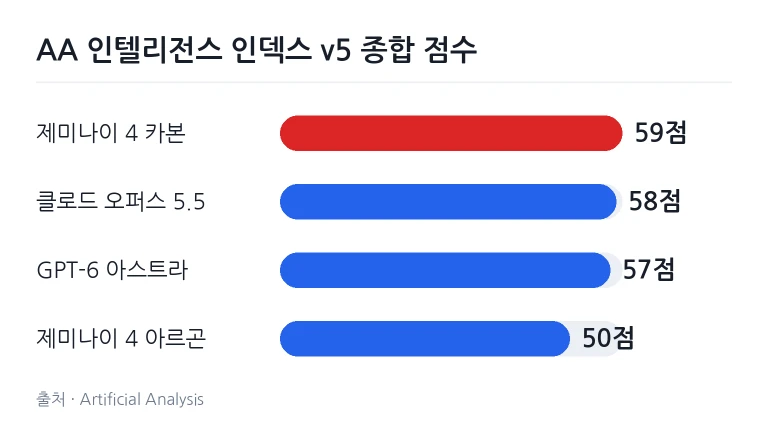
아티피셜 애널리시스 1위 탈환과 경쟁 모델 점수 비교
인공지능 성능 분석 기관 아티피셜 애널리시스(Artificial Analysis)가 발표한 지능 지수(AAII v5) 평가에서 제미나이 4 카본은 추론 강도 최상위 기준 59점을 받아 전체 52개 모델 중 단독 1위를 차지했다. 이 지표는 코딩과 복합 추론, 과학 문제 해결, 전문 작업 등 9개 벤치마크를 합산해 모델의 지적 역량을 측정한다.
직전 선두였던 앤트로픽의 '클로드 오퍼스 5.5'는 58점, 오픈AI의 GPT-6 아스트라는 57점을 기록하며 카본 뒤를 이었다. 2주 전 출시된 제미나이 4 아르곤(50점)과 비교하면 9점 오른 수치다. 구글은 지난해 11월 18일 제미나이 3 프로로 당시 'GPT-5.1'을 3점 차로 누르고 1위에 오른 뒤 약 11개월 만에 앤트로픽과 오픈AI를 제치고 다시 정상에 섰다.
표: 아티피셜 애널리시스 인텔리전스 인덱스(AAII v5) 주요 모델 점수 비교
| 순위 | 모델명 | 개발사 | 종합 점수(점) |
|---|---|---|---|
| 1 | 제미나이 4 카본 | 구글 딥마인드 | 59 |
| 2 | 클로드 오퍼스 5.5 | 앤트로픽 | 58 |
| 3 | GPT-6 아스트라 | 오픈AI | 57 |
| - | 제미나이 4 아르곤 | 구글 딥마인드 | 50 |
*출처: 아티피셜 애널리시스 공식 발표 자료 (추론 강도 하이 기준, 총 52개 모델 평가)
장시간 자율 작업 및 코딩 에이전트 능력
제미나이 4 카본은 며칠에 걸쳐 대규모 소스 코드의 결함을 추적하고 수정할 수 있도록 설계된 장시간 자율 에이전트 구조를 갖췄다. 일회성 코드 완성을 넘어 다단계 작업 계획을 세우고, 중간에 오류가 생기면 스스로 접근법을 바꿔 실행을 이어간다.
구글 내부 실험에서 카본은 지정된 작업 범위를 벗어나는 오류 행동이 26% 줄었고 필수 작업을 빠뜨리는 현상도 29% 감소했다. 코딩 전문 지표인 아티피셜 애널리시스 코딩 에이전트 지수에서 카본은 59점을 얻어 클로드 오퍼스 5.5(62점)에 이어 2위를 기록했다. 개발 환경 제어력을 다루는 '터미널벤치 4.0'에서는 64%, 복합 소프트웨어 개발 과제를 측정하는 '프론티어코드 v1.1'에서는 51%의 정답률로 각각 2위에 올랐다.
사이버 보안 강화와 자체 안전성 제고
제미나이 4 카본은 실제 소프트웨어 환경에서 취약점을 찾아내고 침투 가능성을 검증한 뒤 패치 코드까지 직접 완성하는 종단간 보안 처리 성능을 나타냈다. 구글은 보안 취약점 식별부터 위험성 확인, 수정 코드 작성까지 모델이 자율 처리하는 데 초점을 맞췄다.
취약점 탐지 지표인 'SEC-벤치 프로'에서 88.2%, 실제 공격 가능성을 따지는 '익스플로잇짐(ExploitGym)'에서 54.8%, 취약점 보완 지표인 'CWE-벤치'에서 71.0%를 받았다. 구글은 세 항목 모두 최고 수준 성적이라고 밝혔다. 크롬 브라우저 개발팀 시험에서는 타사 대형 모델과 비교해 고품질 보안 패치 생성 성능이 10배 이상 높게 집계됐다. 외부 지시문으로 동작을 왜곡하는 프롬프트 인젝션 공격 평가에서도 성공률을 아르곤의 0.7%에서 0%로 떨어뜨렸다. 심각한 정렬 위반 경고는 약 80%, 근거 없는 단정적 주장은 약 50% 줄었다.
전문 업무 평가와 운영 비용 및 속도 분석
전문 업무 평가 기관 발스 AI(Vals AI)가 진행한 29개 모델 비교 평가에서 제미나이 4 카본은 종합 70.36%를 기록해 2위를 차지했다. 1위인 클로드 소네트 5.5(70.85%)에 근소하게 뒤졌으나 클로드 오퍼스 5.5(70.18%)는 앞섰다. 세부 부문 중 금융 종합 지수와 법률 연구에서는 1위, 금융 모델링 2위, 세무 에이전트 3위를 기록했다.
다만 꼼꼼한 작업 방식 탓에 토큰 소모와 처리 소요 시간은 늘어났다. 발스 AI 집계 결과 카본은 아르곤보다 출력 토큰을 64% 더 썼고, 금융과 세무 과제 처리에 두 배 넘는 시간이 걸렸다. 법률 연구는 과제당 50분 이상 소요됐다. 반면 금융 모델링과 터미널 코딩 작업은 아르곤보다 빠르게 마쳤으며, 작업당 비용도 10.51달러로 클로드 소네트 5.5(18.70달러)보다 낮았다.
지식 정확도를 측정하는 아티피셜 애널리시스 옴니사이언스 지표에서는 54점으로 1위에 올랐다. 정답률은 아르곤의 48%에서 58%로 상승했으나 환각률은 4%에서 11%로 올랐다. 다만 경쟁 모델인 클로드 오퍼스 5.5와 GPT-6 아스트라의 환각률이 각각 50%에 달해 상대적으로 낮은 편에 머물렀다.
배포 일정과 향후 접근권 확대 계획
제미나이 4 카본은 최대 100만 토큰의 컨텍스트 윈도를 지원하며 텍스트, 이미지, 음성, 비디오 등 다중 모달 입력을 받아 텍스트 결과를 출력한다. 매개변수 규모와 구체적인 학습 신경망 구조는 공개되지 않았다. 초기 응용프로그램 인터페이스(API) 비용은 100만 토큰당 입력 2달러, 출력 10달러이며, 프로모션 할인 종료 후 정가는 각각 4달러와 20달러다.
정가 기준 아티피셜 애널리시스가 산정한 작업당 평균 비용은 7.76달러다. 클로드 오퍼스 5.5(10.04달러)보다 약 23% 저렴하지만 GPT-6 아스트라(6.25달러)보다는 높은 편이다. 구글은 이번 주부터 사이버 보안 전문가들을 대상으로 카본을 먼저 제공하고, '페어윈드(Fairwind)' 프로그램을 거쳐 검증된 협력사로 접근 대상을 넓힌다. 현재 미국 정부의 사전 모델 평가 절차에도 참여하고 있으며, 일반 개발자와 기업 대상의 정식 배포 일정은 피드백 검증 뒤 확정된다.
같은 주제 기사 모아보기
IT테크 관련 기사 더 보기자주 묻는 질문
제미나이 4 카본의 종합 성능 점수는 몇 점인가요?
아티피셜 애널리시스 인텔리전스 인덱스 평가에서 추론 강도 최상위 기준 59점을 기록해 단독 1위에 올랐습니다.
기존 모델 대비 어떤 역량이 주로 강화되었나요?
장시간 자율 작업 계획 능력과 사이버 보안 취약점 탐지 및 패치 코드 생성 능력이 크게 강화되었습니다.
일반 이용자도 바로 사용할 수 있나요?
초기에는 보안 전문가와 협력사 프로그램에 우선 배포되며, 추가 피드백 검증을 거친 후 일반 배포 일정이 확정됩니다.
댓글을 남기려면 로그인 해주세요.